## 결론 먼저
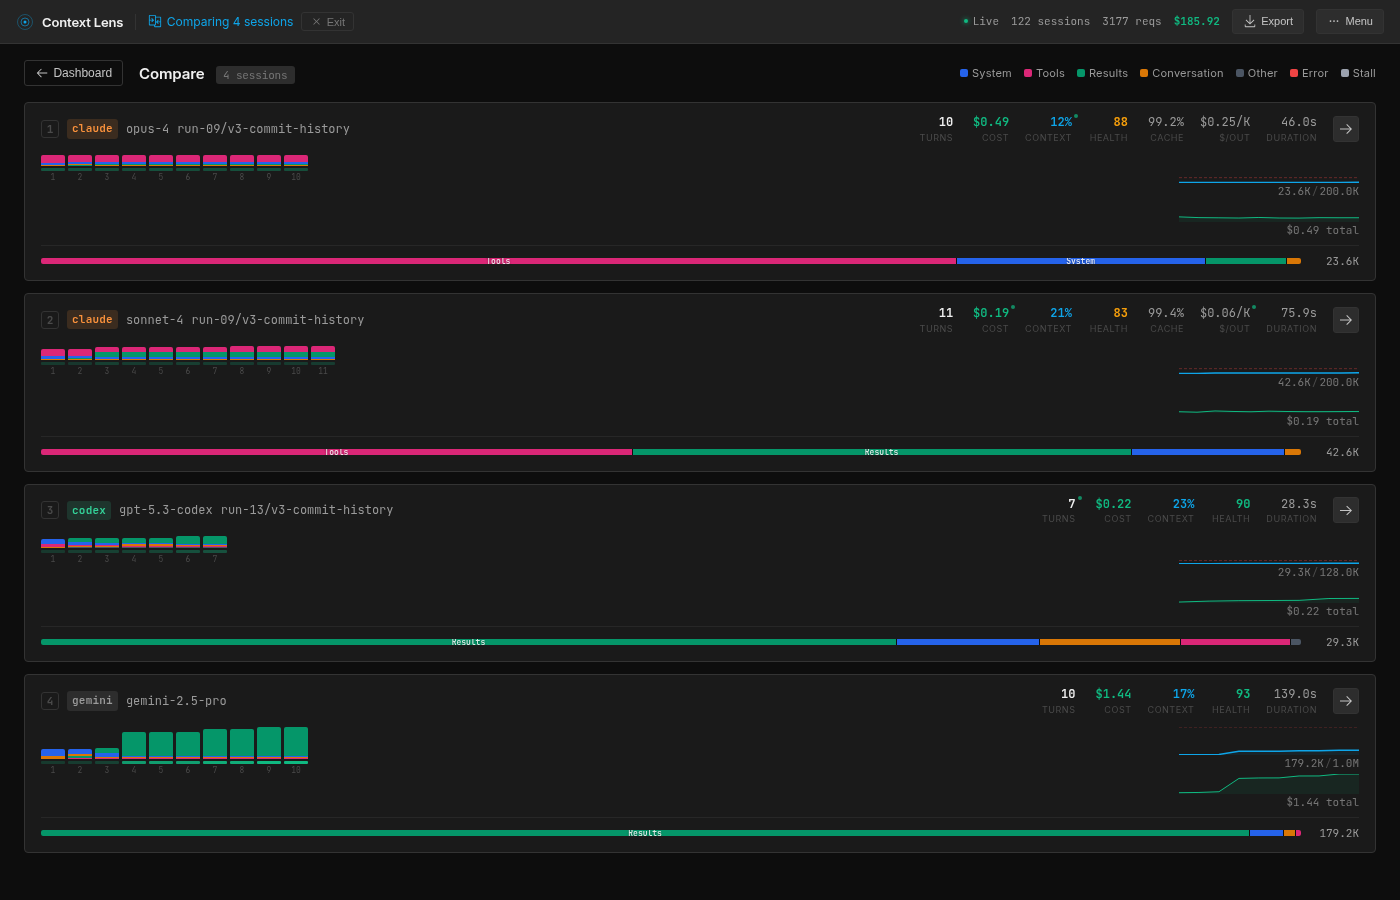
이번 이슈의 핵심은 모델 성능이 아니라 **컨텍스트 운영 방식**입니다. 같은 버그를 고쳤는데도 도구별 토큰 사용량이 23K~350K까지 벌어졌고, 비용·속도·재현성·보안 노출면에서 리스크 프로파일이 완전히 달랐습니다. 이제 AI 코딩 도구 평가는 ‘정답을 맞히느냐’보다 ‘어떤 경로로, 어떤 비용과 데이터 노출로 맞히느냐’로 옮겨가고 있습니다.
## 왜 지금 중요한가
현업 팀은 이미 AI 코딩 도구를 병행 사용하고 있습니다. 문제는 성능 비교표가 대부분 최종 산출물 기준이라, 실제 운영비와 데이터 경계 리스크를 놓치기 쉽다는 점입니다. 이번 3,177회 API 호출 추적 사례는 도구마다 컨텍스트 구성 철학이 다르다는 사실을 수치로 보여줬습니다.
## 핵심 논점
### 1) 같은 성공, 다른 원가: “정답률”만으로는 의사결정이 불가능하다
동일한 Express.js 버그 수정 과제에서 네 도구 모두 테스트를 통과했지만, 토큰 소비량은 큰 편차를 보였습니다. 결과 품질이 비슷해도, 장기 운영비와 응답 안정성은 전혀 다를 수 있다는 뜻입니다.
### 2) 숨은 비용은 모델이 아니라 ‘도구 오케스트레이션’에서 발생한다
일부 도구는 툴 정의를 매 턴 크게 싣고, 일부는 파일/히스토리를 공격적으로 읽어 컨텍스트를 비대하게 만듭니다. 즉 비용의 주범은 모델 단가만이 아니라, 도구가 컨텍스트를 채우는 방식(정적 오버헤드 vs 과도한 읽기)입니다.
### 3) 보안 리스크는 성능 좋은 순간보다 ‘과잉 읽기 순간’에 커진다
대규모 파일 히스토리, 광범위 테스트 로그, 불필요한 디렉토리 읽기가 한 번만 발생해도 민감 정보 노출면이 급격히 넓어집니다. 운영팀 관점에서는 “평균 토큰”보다 “피크 컨텍스트 이벤트”를 감시해야 합니다.
## 실무 시사점
- **모델 벤치마크만 하지 말고, 컨텍스트 구성 로그를 함께 측정**해야 합니다. (turn별 입력 구성, tool result 크기, 캐시 적중률)
- **팀 표준 프롬프트보다 우선해야 할 건 읽기 정책**입니다. (허용 디렉토리, 최대 파일 크기, git log 출력 제한)
- **도구 선택 기준을 단일 점수에서 운영 지표 묶음으로 전환**해야 합니다. (정답률 + 토큰 분산 + 피크 컨텍스트 + 실행시간)
## 오늘 바로 적용할 액션 포인트
1. 파일/히스토리 읽기 상한을 걸어 “과잉 컨텍스트”를 차단하세요. (`max lines`, `git log -n`, `path allowlist`)
2. 파일럿 1주일 동안 도구별 **턴당 토큰 분포(p50/p95/max)**를 기록하고, p95 초과 시 경고 룰을 두세요.
3. 민감 저장소는 프록시 레이어에서 로그/시크릿 마스킹 후 에이전트에 전달하는 구조로 분리하세요.
Tech-Trappist: https://tech-trappist.app
## Sources / References
- https://theredbeard.io/blog/i-intercepted-3177-api-calls-across-4-ai-coding-tools/